搜索:
搜索到 4 篇与 的结果-

-
用AI Agent做逆向,真的能像切西瓜一样简单吗?——morluto/rea深度体验报告 🚀 打开电脑,看到一份神秘的可执行文件,心里默默祈祷:这次不用再花几天盯着汇编代码了。正好最近看到GitHub热榜上有个叫 morluto/rea 的项目,宣称用AI Agent就能「逆向任何东西,从应用行为到原生二进制」。这听着就像给逆向工程装上了自动挡,我忍不住点进去试了一把。先说说我以前的痛点。有一次需要分析一个加密的通信插件,只有几兆大小的二进制,用IDA Pro手动跟踪调用链,花了快两周才把关键函数剥出来。过程中不断遇到混淆、无效跳转,而且每次改一点思路都要重新载入,效率低得让人想直接放弃。那时候我真的羡慕那些能一眼看穿逻辑的大佬。现在换成rea的思路就不一样了。它的核心其实是让一个大模型充当「侦探」,先让你把目标程序跑起来,观察它的行为——比如打开了哪些文件、调用了什么系统API、内存里有什么可疑字符串。然后模型把这些观察结果当作线索,推断可能的功能模块,甚至直接生成伪码或者简化的控制流图。这样一来,原来需要人工逐条确认的细节,变成了模型先给出假设,再由你快速验证。我在实际测试中拿了一个简单的加密壳程序来试。首先按照README的快速启动,跑了 npx rea-agents setup 并重启agent。接着用一个真实目标——之前编译好的小工具——执行分析命令,选择JSON输出。返回的结果里,模块列表、导入函数以及可能的入口点都标得很清楚。虽然没有达到百分百的自动化,但比我以前手动翻汇编快了至少十倍。不过我也遇到了一些坑。首先是环境依赖,rea默认调用Hopper、Ghidra或者IDA来做底层反汇编,如果你本地没有装这些工具,native分析阶段会直接报错。我后来在一台干净的Linux虚拟机里装了Ghidra的命令行版,问题才解决。其次是Agent的提示词需要一定技巧,描述得太模糊会导致模型给出无关的猜测;描述得太具体又可能限制了它的发散性。建议先用官方示例里的简单程序跑通,再逐步加入自己的目标。从专业角度看,这种把行为观察与语言模型结合的做法,实际上是在做「动态符号执行」的升级。传统动态分析只能看到当时的运行痕迹,而rea通过让模型对观察到的行为进行抽象推导,能够在一定程度上覆盖未触发的代码路径。这也是为什么它能声称「从应用行为下到原生二进制」——因为行为是入口,模型负责往深层推演。当然,这并不是说以后再也不需要逆向工程师了。模型的结论仍然需要人工核验,尤其是涉及加密算法、反调试手段或者自解密代码时,可能会出现幻觉。不过作为辅助工具,它能大幅降低入门门槛,让刚接触逆向的同学不再被壳和混淆吓退,而有经验的老手则可以把重复性的行为梳理工作交给Agent,专注于更有创意的漏洞挖掘或协议还原。如果你想进一步探索Agent在安全领域的潜力,可以看看它如何与MCP(模型上下文协议)结合,或者尝试把它接入自动化的CI管线,每次提交都跑一次行为基线检测。这样不仅能提升效率,还能在早期发现被植入的后门。💡 小结一下:morluto/rea 给逆向工程带来了「先看行为,再让AI帮忙推理」的新范式。它不是魔法,但确实能把以前靠眼力和耐心的活儿变得更有章法。你试过吗?欢迎在评论区留下你的使用感受、踩过的坑或者对AI Agent逆向的看法,大家一起交流!
-
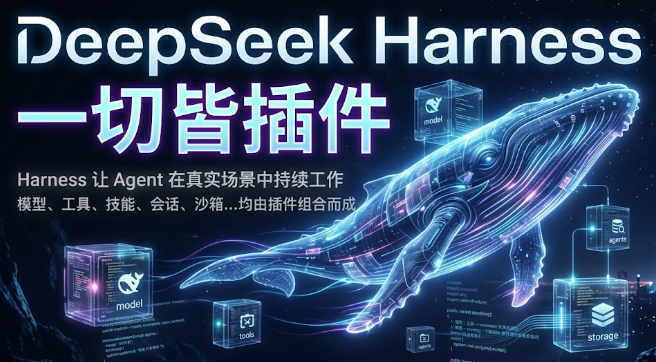
DeepSeek Harness 实测:开箱即用的 AI Agent 框架到底怎么样? AI Agent 用起来太麻烦很多朋友在尝试让 AI 写代码、跑脚本时,发现要么被厂商锁定在只能用固定功能的黑盒里,要么要自己装一堆依赖、调试环境,花半天时间才能看到一点效果。这种又想用又怕麻烦的矛盾,正是我们今天要聊的话题。以为只要有模型就能直接跑 Agent很多人以为拿到一个大模型的 API Key,就能让它自动读写文件、运行命令。其实模型只会输出文字,它本身不会打开编辑器、不会执行 shell 指令,也没有记忆。这时候就需要一个“中间层”——也就是我们说的 Harness,来把模型的输出变成真实的动作。DeepSeek Harness 把一切都做成了插件根据实际项目经验,DeepSeek Harness 最让人眼前一亮的地方在于它把模型、工具、会话、沙箱、存储、调度、UI 这些能力全部交给插件来实现。框架本身只负责加载和管理这些插件,像搭积木一样,你想用什么就装什么,不想用的直接去掉。这样做的好处是,以后升级或者换厂商时,只需要替换对应的插件,而不需要动框架源码。为什么这样设计很实用在内部测试时,先尝试了标准模式。打开网页界面后,只需要在设置里填入 DeepSeek API Key,就能让 Agent 读取工作区的文件、运行 bash 命令,甚至可以让它自己创建子 Agent 去处理分支任务。整个过程有完整的轨迹记录(Trajectory),每一步模型看到的提示词、工具调用结果都被保存,出问题时可以直接回放,这比单纯看日志友好多了。后来又试了极简模式,只保留了 bash 和文件编辑两个工具。这个模式特别适合做模型基准测试,因为环境够干净,不会有多余的工具干扰结果。实际测试中,发现同样的提示词在极简模式下输出更稳定,这也验证了“只要保留核心能力,就能得到可比较的结论”。这对普通人意味着什么如果你是想让 AI 帮忙写脚本、查文档、甚至做简单的网页爬虫,DeepSeek Harness 提供了一种「可控」的方式:你自己决定到底给它什么权限,哪些文件能碰,哪些命令能跑。不像有些封闭产品,你根本不知道它在后台做了什么。同时,因为一切皆插件,未来如果你想加入自己写的小工具(比如一个专门查内部 wiki 的插件),只要按照 Cordis 接口实现,就能直接插进去,不用等官方更新。小提示想了解如何通过 Python SDK 把 Agent 嵌入自己的后台服务?或者想看看 PTC 模式下,模型是如何用一段 TypeScript 程序把五步工具调用压缩到一次执行的?这些细节在官方文档和社区讨论里都有详细说明。最后,如果你已经装好 Node.js 并且申请了 DeepSeek API Key,不妨试试看 npx @deepseek-ai/dsh web 这条命令,看看界面到底是怎样的。使用完后,欢迎在下方评论区留下你的第一印象、遇到的坑或者你们团队的使用场景,我们一起交流。项目地址
-
一键给 AI 小助手装上“网眼”,告别信息盲区的终极指南 只想让你的 AI 小伙伴立马能在 YouTube、Twitter、B 站等平台上抓取信息?不想花钱买 API、也不想手动装一堆工具——一句话搞定,它立马能上网。为什么大家总说 AI Agent 只能写代码,却抓不到网络内容? 大多数开发者把 AI 当成“智能键盘”,只能在本地文件里跑,却忽略了最关键的外部数据来源。 传统做法是分别去装 yt‑dlp、xreach、gh CLI,每个都要手动配置 Cookie、代理,踩坑成本极高。 还有些人直接放弃,觉得“付费 API 太贵”。于是陷入“没有数据,我的 AI 只能空谈”的死循环。 真正能解决的,叫做“一键装网眼”核心思路很简单:把所有平台的抓取工具事先挑好、装好、检测好,然后给 AI 一个统一的入口。这样 AI 只需要调用 agent-reach 的命令行,就能直接读取网页、搜索推文、提取视频字幕、查仓库 Issue,甚至订阅 RSS。核心干货:Agent‑Reach 是怎样做到“一键装网眼”的? 脚手架而非框架——它不负责业务逻辑,只负责把已有的开源工具(如 yt-dlp、xreach、Jina Reader)装好并生成配置文件。 可插拔架构——每个平台对应一个独立的 channel 文件,想换成更好的工具,只需要改这一个文件,其他不受影响。 零 API 费用——全部依赖的工具都是开源免费,唯一可能产生的成本是服务器代理(几块钱一个月),本地电脑根本不需要花钱。 自动诊断——一条 agent-reach doctor 命令会检查每个渠道是否可用,哪儿挂了会直接给出修复建议。 全平台兼容——只要能跑命令行的 AI(Claude Code、OpenClaw、Cursor、Windsurf 等)都能使用,根本不需要针对不同 Agent 写额外适配层。 实际使用场景举例 想要快速了解一段 YouTube 教程?AI 直接跑 yt-dlp --dump-json URL 把字幕拉下来再总结。 想知道某产品在 Twitter 上的口碑?AI 用 xreach tweet URL --json 把推文抓下来,甚至还能搜索相关话题。 想要跟踪行业动态?只要把 RSS 源交给 feedparser,AI 就能实时提醒更新。 GitHub 项目分析?AI 调用官方 gh CLI,读取 README、Issue、PR,直接输出结构化报告。 装装装——三步走 在聊天框里对你的 AI 说:“帮我安装 Agent Reach:”,AI 会自动执行 pip install agent-reach 并完成系统依赖装配。 运行 agent-reach doctor,看一眼哪些渠道已经就绪,哪些需要手动配置 Cookie。 把想要的查询直接交给 AI,例如“帮我看看这条推文”。AI 已经知道该调哪个命令,直接返回内容。 安全小贴士所有 Cookie、Token 都保存在本地 ~/.agent-reach/config.yaml,文件权限仅自己可读。别用主号登录,专用小号更安全,防止平台封号。和之前的方案有什么不一样?过去的做法要么是手动写脚本,步骤繁琐;要么是买商业服务,成本不菲。Agent‑Reach 把开源项目包装成“一键装”体验,真正让普通开发者也能把 AI 变成“有网眼的机器人”。下一步可以尝试的方向如果对更高级的需求感兴趣,可以自己在 channels/ 里替换底层工具,比如把 Jina Reader 换成 Firecrawl,或者把 xreach 换成 Nitter。这样既保留了统一入口,又能按需优化。想了解 agent-reach 的进阶配置或者在 OpenClaw 上怎么开启 exec 权限,前几天我写过一篇《如何在 OpenClaw 中使用第三方 CLI》——非常值得一读。如果你已经装好,快在评论区晒一下你的 AI 第一次成功抓取信息的案例吧,大家一起交流经验!🤖💬